MiniMax 创始人闫俊杰私下说了一句"Anthropic 用了 looped,这是共识性的事情",这句话在中文 AI 圈流传甚广,却查不到任何公开来源。把它和上海 AI 实验室同一时期发表的质疑论文放在一起,张力就出来了:一边是产业里"大家都在盯"的方向感,一边是学术界"looped 的收益部分靠表征退化换来的"的冷水。Loop Transformer 到底是下一个范式,还是一个被高估的 trick?这篇把 2026 年四篇核心文献读穿之后,我的结论比这两个极端都更克制,但也更有用。
01它到底是什么:权重共享的循环
标准 Transformer 是层叠结构——L 个参数各自独立的 block 串联,信号从第 1 层单向流到第 L 层,每层用自己的权重做一次变换,走到头就输出。Looped Transformer 把这个结构改成权重共享的迭代循环:只保留一组(或很少几组)block 的权重,把它的输出再喂回输入,反复跑 R 次,第 t 次的输出就是第 t+1 次的输入。整个模型增加的几乎只有"循环次数"这一个维度,参数量并不涨。
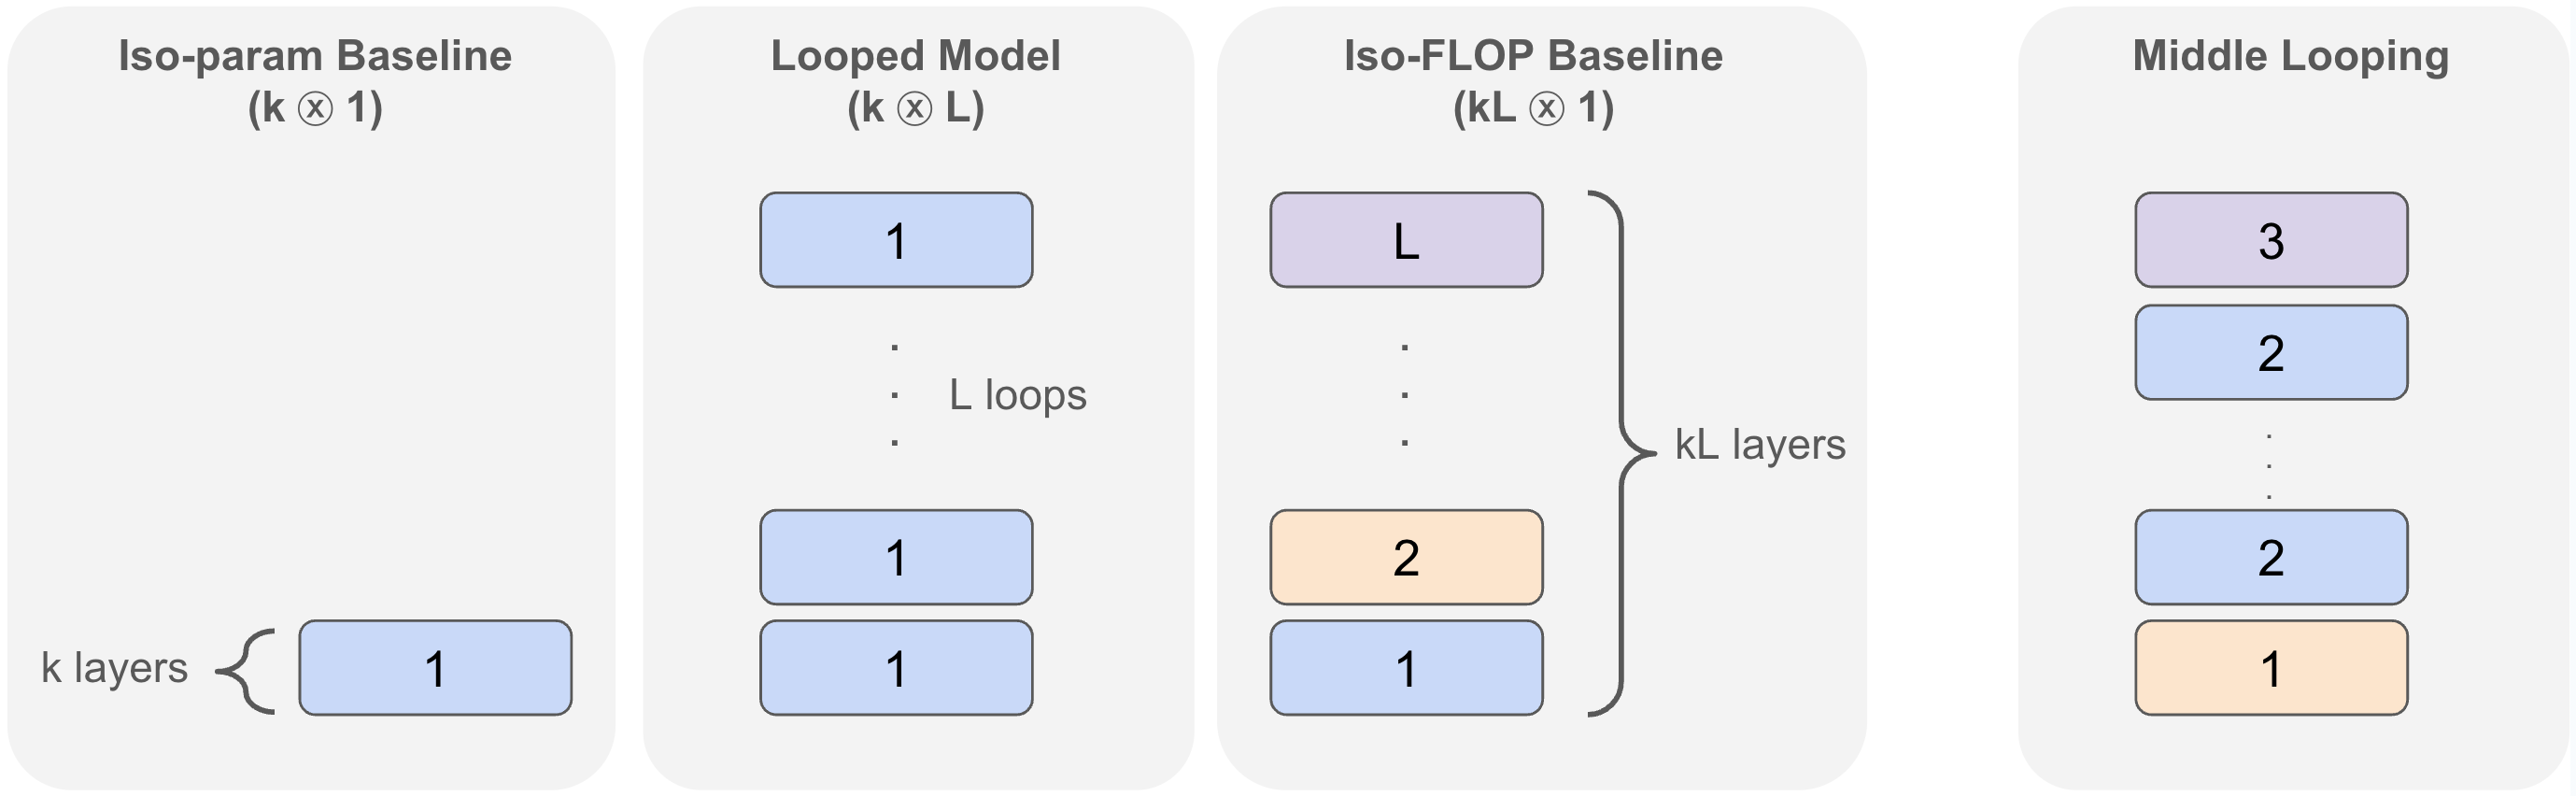
这条思路 2019 年就有了——Dehghani 等人的 Universal Transformer 第一次把"按深度递归"塞进 Transformer,还引入了 Graves 的 Adaptive Computation Time 让每个 token 动态决定算几步。但 UT 的 ACT halting 分布在规模化训练里梯度不稳、per-token 动态步数又损害 GPU 并行效率,被 GPT/Claude/Llama 等主流大模型集体否决。直到 2024 年 Yang 等人证明单层循环约 20 次能匹配 12 层标准 Transformer、并找到 input injection 这个稳定化关键,再到 2025 年 Saunshi(Google DeepMind)和 Geiping(UMD)把它推到 1B-3.5B 大规模预训练,这条线才算真正工程化。
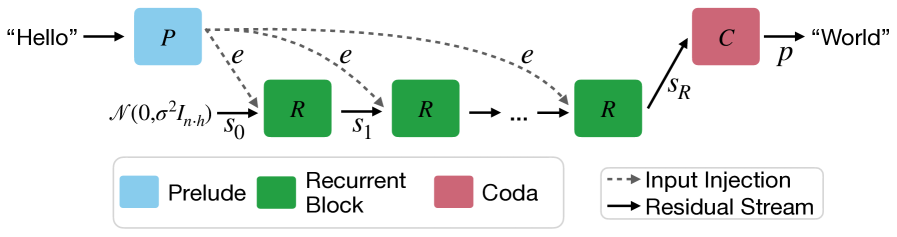
2026 年进入密集落地期,四篇核心文献同台:字节 Seed 的 Ouro(7.7T tokens,1.4B/2.6B 开源)、Together AI 的 Parcae(首次给出 scaling laws)、OSU 的 Loop-Think-Generalize(证明深度外推能力)、上海 AI 实验室的 Loop as a Bridge(对 Ouro 的内省能力提出质疑)。把这四篇加上 Huginn 和 Saunshi 一起读,Loop Transformer 的全貌就清楚了。
02好还是不好:一笔结构性交易
这是最核心的判断。说它只是参数压缩 trick 不准确,有两条硬证据;说它是全面范式转变也不准确,有三条反方。先看正方。
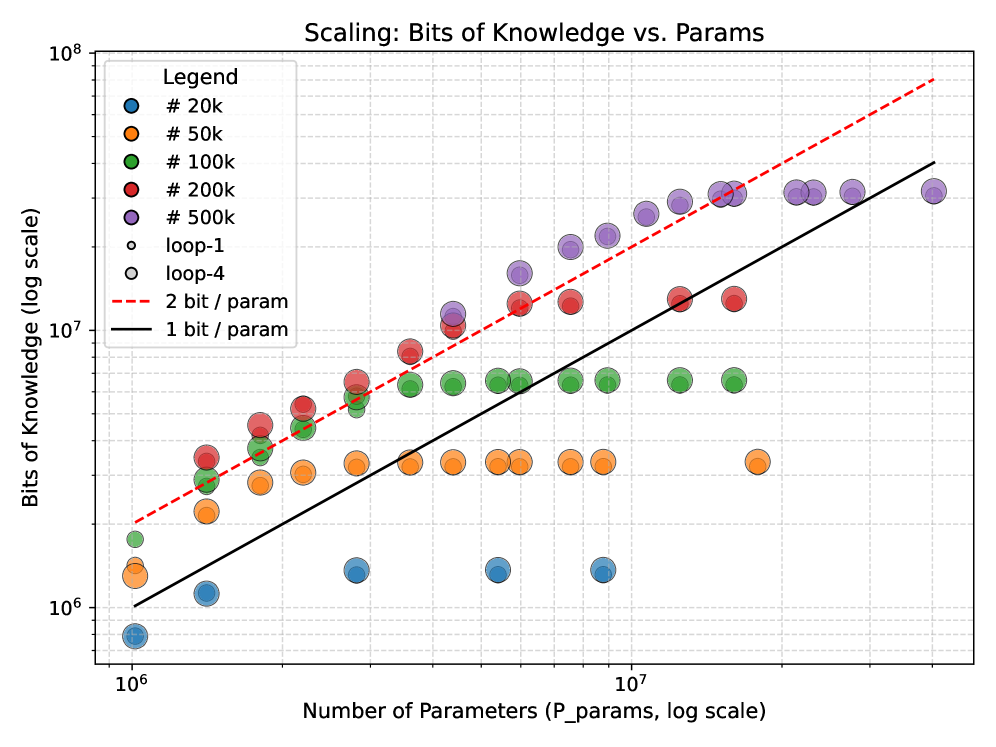
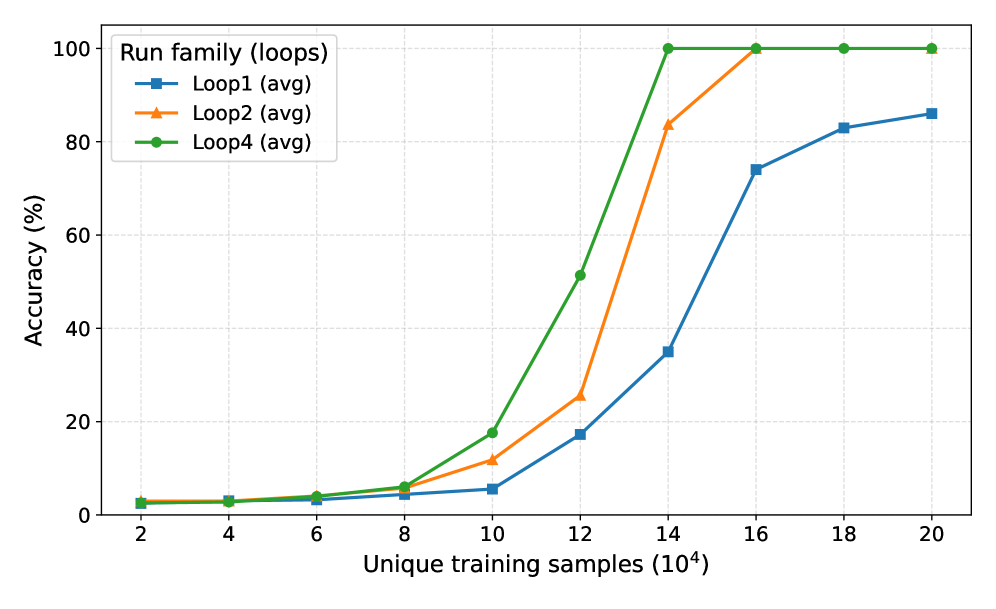
第一,Ouro 的 Capo/Mano 分离实验直接拆开了"存储"和"操控"。Capo 任务证明 loop 不增加 per-parameter 知识存储容量——无论循环几次,知识比特数都贴着 2 bit/param 的参考线,looped 与 non-looped 几乎重合;Mano 任务证明 loop 显著增强多跳知识操控——Loop4 用不到 Loop1 一半的训练样本就达到 100% 准确率。
第二,Saunshi 的 iso-plot 给了更强的论证:在相同 perplexity 下,looped 模型的 reasoning 曲线始终高于 baseline,而 memorization 曲线重合。如果只是参数 trick,等 perplexity 下不该有 reasoning 的额外增益。第三,Parcae 的 scaling law 给了独立幂律——固定参数预算下,最优 loop 深度 μ_rec ∝ C⁰·⁴⁰、数据 D ∝ C⁰·⁷⁸,trick 不会服从幂律。
但反方同样硬。最重的一条来自 Ouro 论文自己的附录 D.1:在严格控参控数据的对比里(53M-1.36B,同参数同数据),标准 Transformer 持续优于 LoopLM,8 步循环甚至比 4 步差。这意味着 looped 没有必胜优势,Ouro 的 benchmark 优势部分来自训练规模(7.7T tokens)和任务选择性。更致命的是新论文"Loop the Loopies"指出的算力账问题:looping N 次预训练也把训练算力乘了 N,所以"2-3 倍参数效率"在同等预训练算力预算下可能根本不成立——之前所有"小模型匹配大模型"的叙事都在用参数量当分母,没用训练 FLOP 当分母。
Looped Transformer 是一笔用通用语言建模能力换迭代推理能力的结构性交易。它买到的不是"更大的脑子",而是"同一个脑子多想几轮"的能力——所以 perplexity 始终更差(覆盖 34-50% gap),但推理型任务上小参数能逼近大模型。这不是免费午餐,是窄带交易。
落到性价比,要分两个分母看。per-parameter 极好:2.6B 显存跑出 8B 推理水平,参数效率 2-3 倍。per-FLOP 为负:4 倍前向计算加上预训练算力放大 N 倍,同等算力下标准 Transformer 反而更优。所以它的性价比符号完全取决于卡在哪个瓶颈:卡显存,正收益;卡算力,负收益。这条分界线是硬的。
03为什么好:机制的深处
机制上,looped 的增益来自两件事,而且是一枚硬币的两面。权重共享迫使模型学一个可复用的计算原语,而不是把不同子任务焊死在不同层。标准 Transformer 的层是功能特化的——第 17 层干这件事、第 23 层干那件事,知识存在特定层里。权重共享打破了这种特化,逼模型学"怎么思考"这个可迭代的算子。这就是为什么 Saunshi 的 iso-plot 显示等 perplexity 下 reasoning 依然更强——共享权重是一种 inductive bias,逼模型学过程而不是记位置。
也正是这个机制让 perplexity 更差——因为知识存储本来就是"一层专做一件事"更高效,权重共享牺牲了功能特化。所以 manipulation 涨、storage 跌,是同一个机制的两面,不是两个独立的优点和缺点。这解释了为什么 looped 永远不可能在通用能力上全面超越标准 Transformer:它结构性放弃了功能特化。
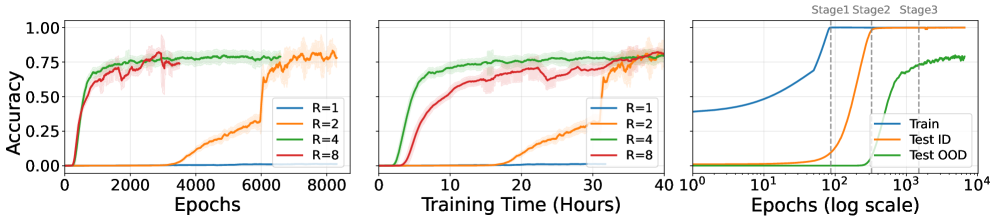
它真正给得了而标准 Transformer 给不了的,是动态深度。标准 Transformer 训练完深度就锁死,32 层就是 32 层,简单 token 也得跑满、难 token 也只能跑那么多;looped 让推理时算力可调,简单 token 早退、难 token 多 loop。这是结构性差异,不是调参。OSU 的 Loop-Think-Generalize 用一个三阶段 grokking 动态展示了这种"真新能力"的涌现:vanilla Transformer 在系统泛化上 OOD 准确率为 0%,而循环深度 R≥2 就解锁,经过"记忆→ID 泛化→系统泛化"三个阶段最终涌现。
04Scaling Law 的真相:第三轴还是小规模 artifact
Parcae 最被引用的结论是"looping 是独立于参数和数据的第三正交 scaling 轴"。这个论断要打折扣。对抗核查后,数字本身无误——固定 FLOP 预算下 compute-optimal 训练确实要同时增加 loop 深度和数据,服从 μ_rec ∝ C⁰·⁴⁰、D ∝ C⁰·⁷⁸ 的幂律。但这个结论只在 140M 和 370M 两个小规模上验证过,而且"参数-数据-recurrence 三轴联合正交"论文自己列为 future work。"独立于参数量"是过度外推,外推到 10B+ 不成立。
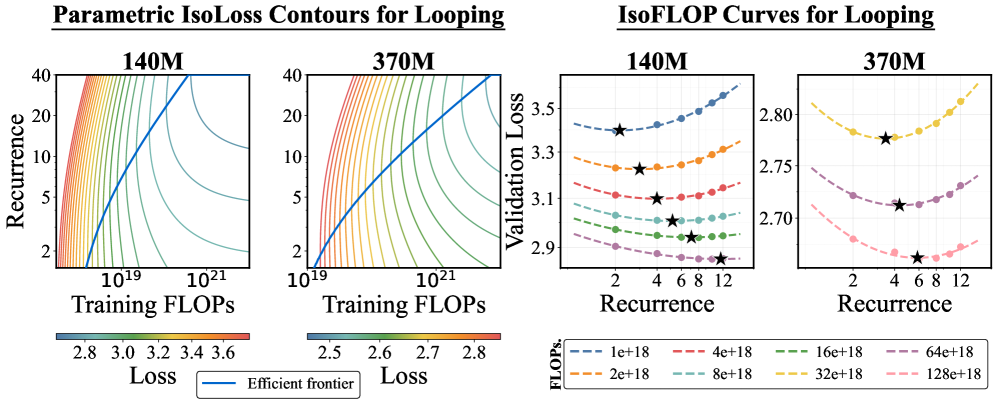
Parcae 的另一贡献是稳定化:把残差流重铸为非线性时变动力系统,通过负对角参数化 + ZOH 离散化从构造上保证谱半径 ρ(Ā)<1,解决了 looped 训练的残差爆炸和 loss spike。它用这个稳定架构把 1.3B 模型做到 2 倍大小 Transformer 87.5% 的质量(CORE 指标高 2.99 分)。但这个 87.5% 是跨规模的上限值,且主要来自 770M 这个规模点,不是 1.3B 单点结果。
05三重天花板
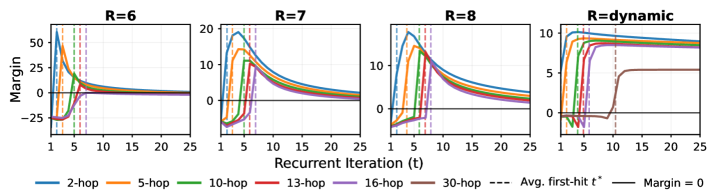
looped 的代价集中体现在三重天花板。第一重是 overthinking:循环次数过多性能反而掉。OSU 的 logit margin 曲线清楚展示这个先升后降——margin 在迭代初期上升(推理置信度提高),达到峰值后随迭代增加而下降,约 15 次迭代后趋近于零。
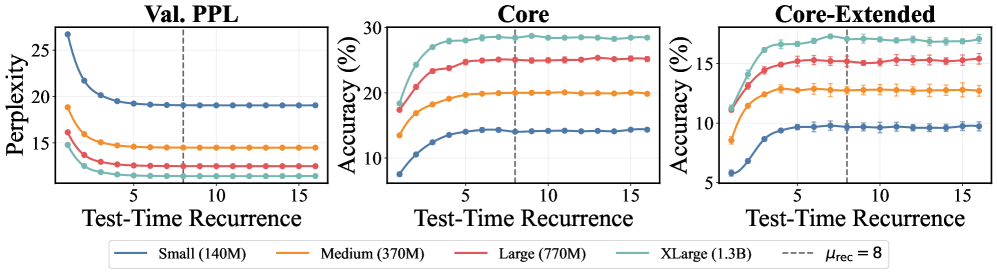
第二重是推理外推的硬天花板:Parcae 发现 test-time 的 gain 在训练深度约 2 倍处 plateau,意味着 looped 无法像 CoT 那样"训练时少算、推理时多算"无限放大。这对押注 inference-time scaling 的人是关键区别——looped 的推理时算力外推天花板远低于 CoT。
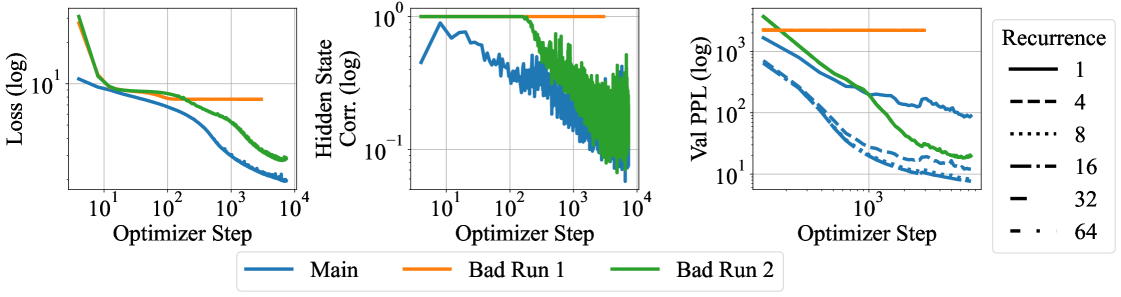
第三重是训练稳定性的工程代价。Huginn 经历了两次 Bad Run 才找到正确配置——第一次 hidden state 坍塌(相关性归零)、第二次循环被模型完全忽略(退化为单次前向),直到用 sandwich norm + 拼接 adapter 才成功。Ouro 训练时被迫把循环步数从 8 降到 4 保稳定,RL 阶段也没拿到显著增益。循环训练的脆弱性远超标准 Transformer,这是商用规模未被采用的核心原因。
06谁在用:四层证据
商用落地要严格分四层看,不能混。第一层是开源有实证:Ouro(字节 Seed,Apache-2.0,HuggingFace 可下载)、Parcae(Together AI,MIT,PyPI 包)、Huginn(UMD,开源)、Saunshi(Google DeepMind 实验)。这四组全部标注 research only,无生产部署。第二层是商用生产模型,零实证——Apple AFM 3 用 MoE、Meta Llama 4 用 MoE+NoPE、Google Gemini 3 标准架构、OpenAI 无 looped 线索,没有任何一家大厂公开声明生产模型用了 looped。
第三层是商用 rumor,仅 Anthropic 一家,且是零证据猜测。Claude Mythos 确实存在(2026 年 3 月因 CMS 配置错误泄露约 3000 份资产,Anthropic 确认它是"step change"、能力超 Opus 4.6),但 Mythos 用 looped 架构没有任何一手证据,只有一个 LinkedIn 帖子把 Ouro 预测的 graph-search 优势和 Mythos 的高分联系起来做了猜测。闫俊杰那段"Anthropic 用了 looped、这是共识"查不到任何公开来源,很可能是私域传话或接了同一条社区 rumor 链。但"共识性"这个元判断本身有信息量——它说明产业内部已过了"这是 fringe"的阶段,进入"认真评估"。第四层是间接相关:Dr.LLM(ICLR 2026)的 layer repeat/skip/execute 路由是 retrofit 对照路线,MoDr 给 Huginn 加多分支路由改进单链,这些是动态深度的不同实现,不是权重共享循环。
所以准确判断是:产业尚无生产级实证,全在实验阶段;字节是离商用最近的实体(Ouro 在 Seed 研究线,与 Doubao 产品线隔离),谷歌 DeepMind 有 Saunshi 研究背书,Anthropic 是唯一有 rumor 的前沿实验室但零确认。闫俊杰说"共识"更像是"大家都在盯",不是"大家都在用"。
07硬件需求的结构性翻转
这是这条线最值得投研展开的部分。表面逻辑是"利空内存、利好计算",但太粗会误判,因为内存和计算各自内部分化得很厉害。
内存不是单边利空,是结构分化。权重显存这一层确定性下行——Ouro 2.6B 跑出 8B 推理水平,权重显存直接砍到三分之一,这是 looped 最硬的收益。KV cache 这一层是 mixed:looped 在 decoding 阶段可以 sharing/overwrite 降到常数倍,但 prefill 阶段不能复用,长上下文 prefill 的显存压力还在。训练内存更是 mixed 偏空——权重共享让优化器态只有一份(利好),但反向传播要把每个循环步的激活都存下来,激活内存随循环步数线性涨(利空)。所以"利空内存"的精确版是:推理侧权重显存确定性下行,训练侧激活内存上行,HBM 需求是结构分化而非单边——推理 HBM 弱、训练 HBM 强。
计算也不是单纯利好。推理算力是确定利好(4 倍前向 FLOP + adaptive exit 可调),但训练算力被循环次数放大 N 倍——这对算力供应商是利好,对模型公司的训练成本是利空。落到 GPU 上是 mixed:训练侧仍需高端(Huginn 在 AMD MI250X 上训),推理侧高端 GPU 的护城河被削弱,因为 compute-bound 推理可以用更多中端制程芯片堆叠来补,量补质。
通信与互联是被严重低估的利空角度。looped 模型小,单机少卡就能装下,减少了对大集群多卡并行的依赖。标准 Transformer 推理为装下大模型要 tensor parallel 跨卡切、训练要 pipeline parallel 跨机切,这些都吃 inter-node 互联(光模块、InfiniBand)。looped 把模型做小后,data parallel 就够了,模型小梯度小通信量也小,inter-node 互联需求结构性下降。这落到投资上是个和内存平行的"高位股被杀"角度:光模块和 IB 的高估值建立在"大模型必须大集群"这个前提上,looped 如果规模化,这个前提被松动。NVLink 这种 intra-node 互联中性偏稳,inter-node 的光模块压力更大。
端云结合是 looped 的杀手级场景。端侧芯片的特征就是显存极受限、算力相对充裕——手机 NPU 算力不弱但内存就几 GB,正好匹配 looped"小参数多算力"的轮廓。端侧模型从 7B 降到 2B 跑同等推理水平,是端侧 AI 渗透的钥匙。但前置硬障碍是量化:循环会递归放大量化噪声,标准 PTQ 在 W4A4 下若移除循环感知组件 accuracy 暴跌 56.6%(LoopQ 的测量),端侧必须 4-bit 才塞得下,所以循环感知量化是端侧落地必经之路。
中美竞争是最锐的维度。表面逻辑利空中国:looped 把瓶颈从内存(中国相对强)挪到算力(中国相对弱)。但算力卡脖子的本质是顶制程 GPU 的制造(台积电 3nm/2nm + 光刻机),不是"算力"这个抽象量。looped 推理是 compute-bound,而 compute-bound 推理可以靠更多中等制程芯片堆叠来满足——中国在中端制程(中芯国际成熟节点)有产能。所以如果 looped 把推理算力需求从"少数顶制程大卡"转向"大量中端制程芯片",它反而可能用架构绕开制程壁垒,把卡脖子的点从"制程"挪向"算力密度/互联/能耗/架构创新"这些中国有追赶空间的地方。但训练侧没这么乐观——looped 训练仍需高端加速器,而且放大训练算力 N 倍反而加深对高端 GPU 的依赖。所以 looped 对中国是"推理侧可能绕开壁垒、训练侧加深依赖"的分裂格局。
利空:推理侧权重显存占比高的 HBM 配置、inter-node 光模块/IB 互联厂、存算一体(它解决内存墙,而 looped 缓解内存墙却加剧计算墙)。
利好:中端制程算力芯片、推理 ASIC(算力密度优先架构)、looped 原生推理引擎软件栈、端侧芯片、数据中心电力。
分化:高端 GPU(训练利好推理承压)、NVLink intra-node、HBM(训练强推理弱)。
08反方证据与证伪条件
最该警惕的反方是上海 AI 实验室的 Bridge 论文。它用概念注入实验直接质疑 looped 的内省能力:检测能力集中在最后一个 loop,中间循环几乎没有内省意识——gap 缩小部分是靠表征探针性能退化驱动的"向下对齐",不是真正的持续反思。这把"loop = 更深思考"的叙事打了个洞。但作者自己声明这仅基于 Ouro 单一实例,不应被解读为 LT 范式的内在缺陷——所以它是警示,不是终审判决。
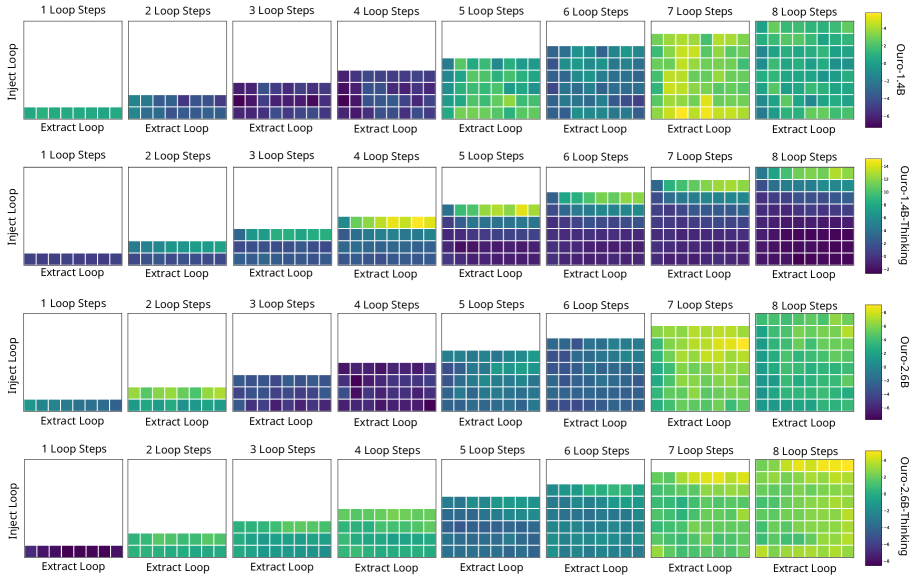
所以人脑类比要诚实:looped 真正同构的是"迭代精炼"这个计算原语(皮层柱的 reentrant signaling、predictive coding 的不动点求解、ACT 的难度依赖分配),不是"一遍遍有意识地反思"。把 looped Transformer 说成"像人一样反复思考"是过度浪漫化。一个更深的质疑来自 DEPTH 的发现:标准 LLM 的有效深度比例稳定在 0.6-0.7,long-CoT 训练不增加有效深度——如果标准 Transformer 深层已隐式在做循环做的事,显式循环的增量价值是否足以支撑范式转移?这是对整个 looped 叙事最深的质疑。
所有这些判断都挂在一个前提上:looped 必须成为主流。而它 10B+ 规模的稳定性至今没解决,Parcae/Ouro 全在 1-3B 验证。所以这套硬件影响是 conditional 的。我给三个证伪触发器:如果未来一两年内有头部大厂把 looped 推进 10B+ 生产模型并解决稳定性,我的"渐进优化"判断偏保守,它可能升级为局部范式;如果 Ouro 之后没有跟进者、或 7B+ 规模稳定性始终过不了,looped 就停在推理特化小模型利基,判断确认;如果 HBM4 量产让显存价格大幅下行,looped"显存换算力"的杠杆价值本身就被削弱。
最该盯的一个领先指标:看谁率先在 API 里暴露 adaptive compute depth 或 test-time compute 的 per-token 计费选项。一旦有大厂这么做,说明 looped 或同类 latent reasoning 已经进了生产,上面这套硬件影响就开始兑现。在那之前,内存股和光模块股的高位是靠"大模型大集群"叙事撑着的,looped 是悬在这个叙事上的边际风险,不是即刻的崩塌。
技术方向我七八成把握 looped 是真信号,但"改变硬件需求结构"的时间表我只有三四成把握在三年内发生,更多是三到五年的慢变量。它值得放在观察清单上,但不值得现在就为它重新定价整个算力链。
• Dehghani et al. 2019, Universal Transformers(arXiv:1807.03819)
• Yang et al. 2024, Looped Transformers are Better at Learning Learning Algorithms, ICLR 2024(arXiv:2311.12424)
• Saunshi et al. 2025, Reasoning with Latent Thoughts: On the Power of Looped Transformers(arXiv:2502.17416)
• Geiping et al. 2025, Scaling up Test-Time Compute with Latent Reasoning: A Recurrent Depth Approach / Huginn, NeurIPS 2025(arXiv:2502.05171)
• Zhu et al. 2025, Scaling Latent Reasoning via Looped Language Models / Ouro, ByteDance Seed(arXiv:2510.25741)
• Prairie et al. 2026, Parcae: Scaling Laws For Stable Looped Language Models, Together AI(arXiv:2604.12946)
• Kohli et al. 2026, Loop, Think, & Generalize: Implicit Reasoning in Recurrent-Depth Transformers, OSU(arXiv:2604.07822)
• Chen et al. 2026, Loop as a Bridge, 上海 AI 实验室(arXiv:2601.10242)
• Heakl et al. 2026, Dr.LLM: Dynamic Layer Routing in LLMs, ICLR 2026(arXiv:2510.12773)
• Loop the Loopies!(arXiv:2607.16051)——对 looped 算力账的批评