把一份 51 页的技术报告读完,最强烈的感受是它的克制。这一代没有换范式,没有发明新的训练算法,甚至在 post-training 章节里直接写了一句 “our post-training introduces no algorithmic innovation”。所有真正的改动都发生在架构与系统层,并且服务于一个非常具体的工程约束:agent 时代的工作负载是输入密集型的——一次任务要读进去几十万 token 的代码库、文档和对话历史,吐出来的可能只有几千 token。
这种形状的负载把成本结构整个翻转了。输入部分的计算(prefill)成了大头,而 KV cache——Transformer 推理时缓存历史 token 的 key/value 张量,作用是避免每生成一个新 token 都重算全部历史——的占用和搬运成了真正的瓶颈。报告开篇的判断很直接:算力、存储、带宽这三件事的合力构成了部署的主要障碍,而单纯降低计算成本已经不够了。
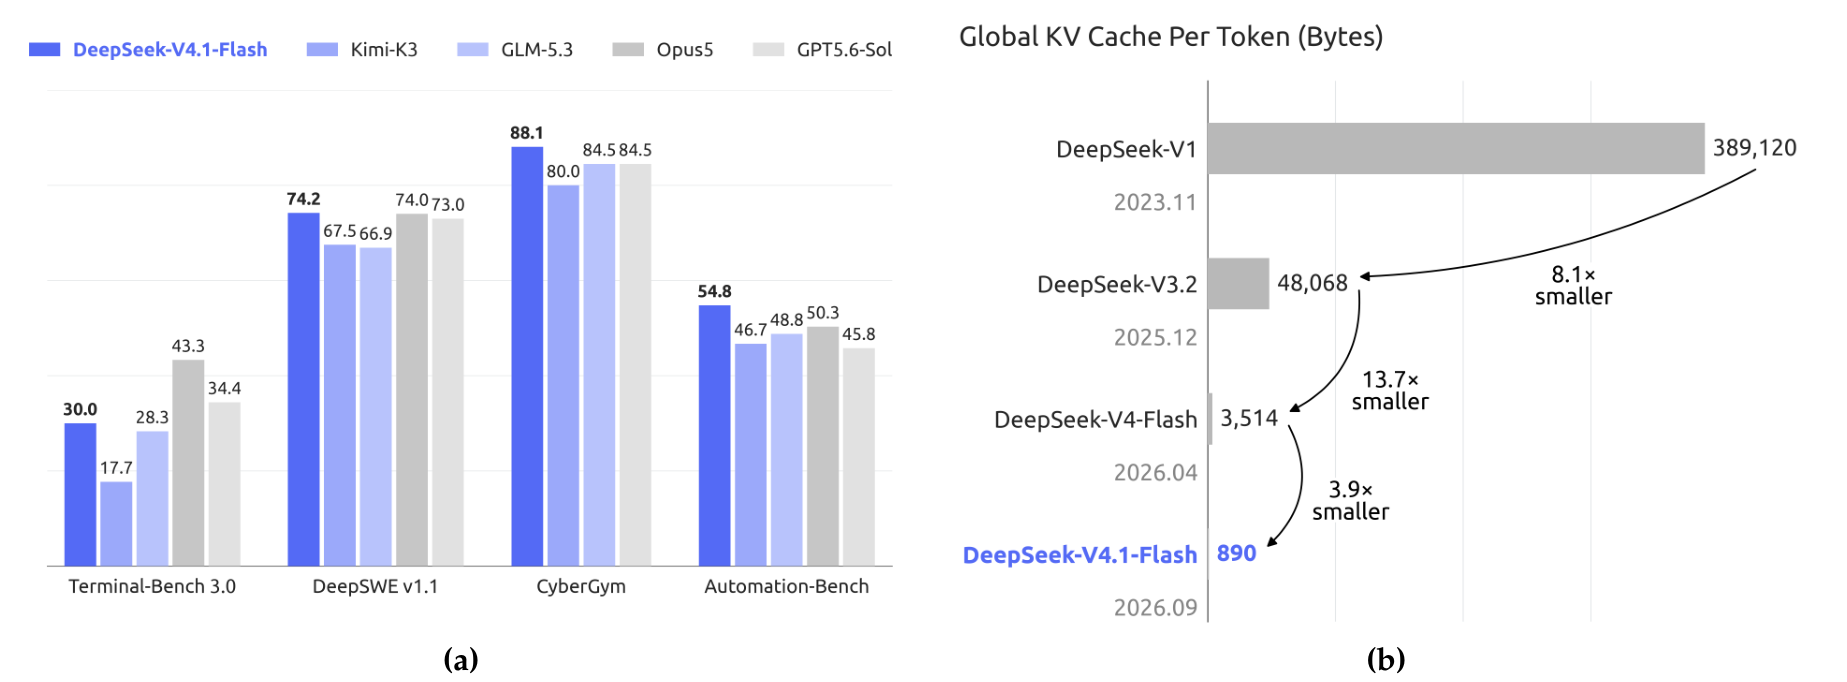
先把家底交代清楚。V4.1-Flash 是 552B 总参数的 MoE,原生多模态输入,支持 100 万 token 上下文,40 层 Transformer 里每层挂 1 个共享专家和 384 个路由专家、激活 6 个。真正的结构变化在下一条。
01CED:让 prefill 只跑一半的层
这一代最核心的结构创新叫 Causal Encoder-Decoder(CED)。要理解它,得先把“causal encoder”这个词拆开——它是个缝合词。Causal 说的是注意力约束:每个位置只能看见自己和左侧的 token,不能看右边,因为语言模型是自回归生成的,预测第 100 个词时现实中只有前 99 个词存在,训练时若允许偷看右侧等于开卷考试。Encoder 借自 2017 年原始 Transformer 的分工——编码器负责把输入读懂、用双向注意力,解码器负责生成、用因果注意力。V4.1 的 causal encoder 拿走了 encoder 的功能定位(把输入编码成表示),保留了因果注意力(因为整个模型仍是自回归的)。
落到实现上,40 层被切成前 20 层 causal encoder 加后 20 层 decoder,而关键设计是:decoder 层的 KV 不再从自己的 hidden state 投影,而是直接从第 20 层(encoder 最后一层)的 hidden state 用各层自己的压缩权重投影出来。这意味着 prefill 时,绝大部分 prompt token 只需要穿过 encoder 的 20 层就可以停下——上层要用的全局 KV 在第 20 层就已经全部生产完毕。整段复杂度从 O(NL) 降到约 O(NL/2),prefill 计算量接近腰斩。
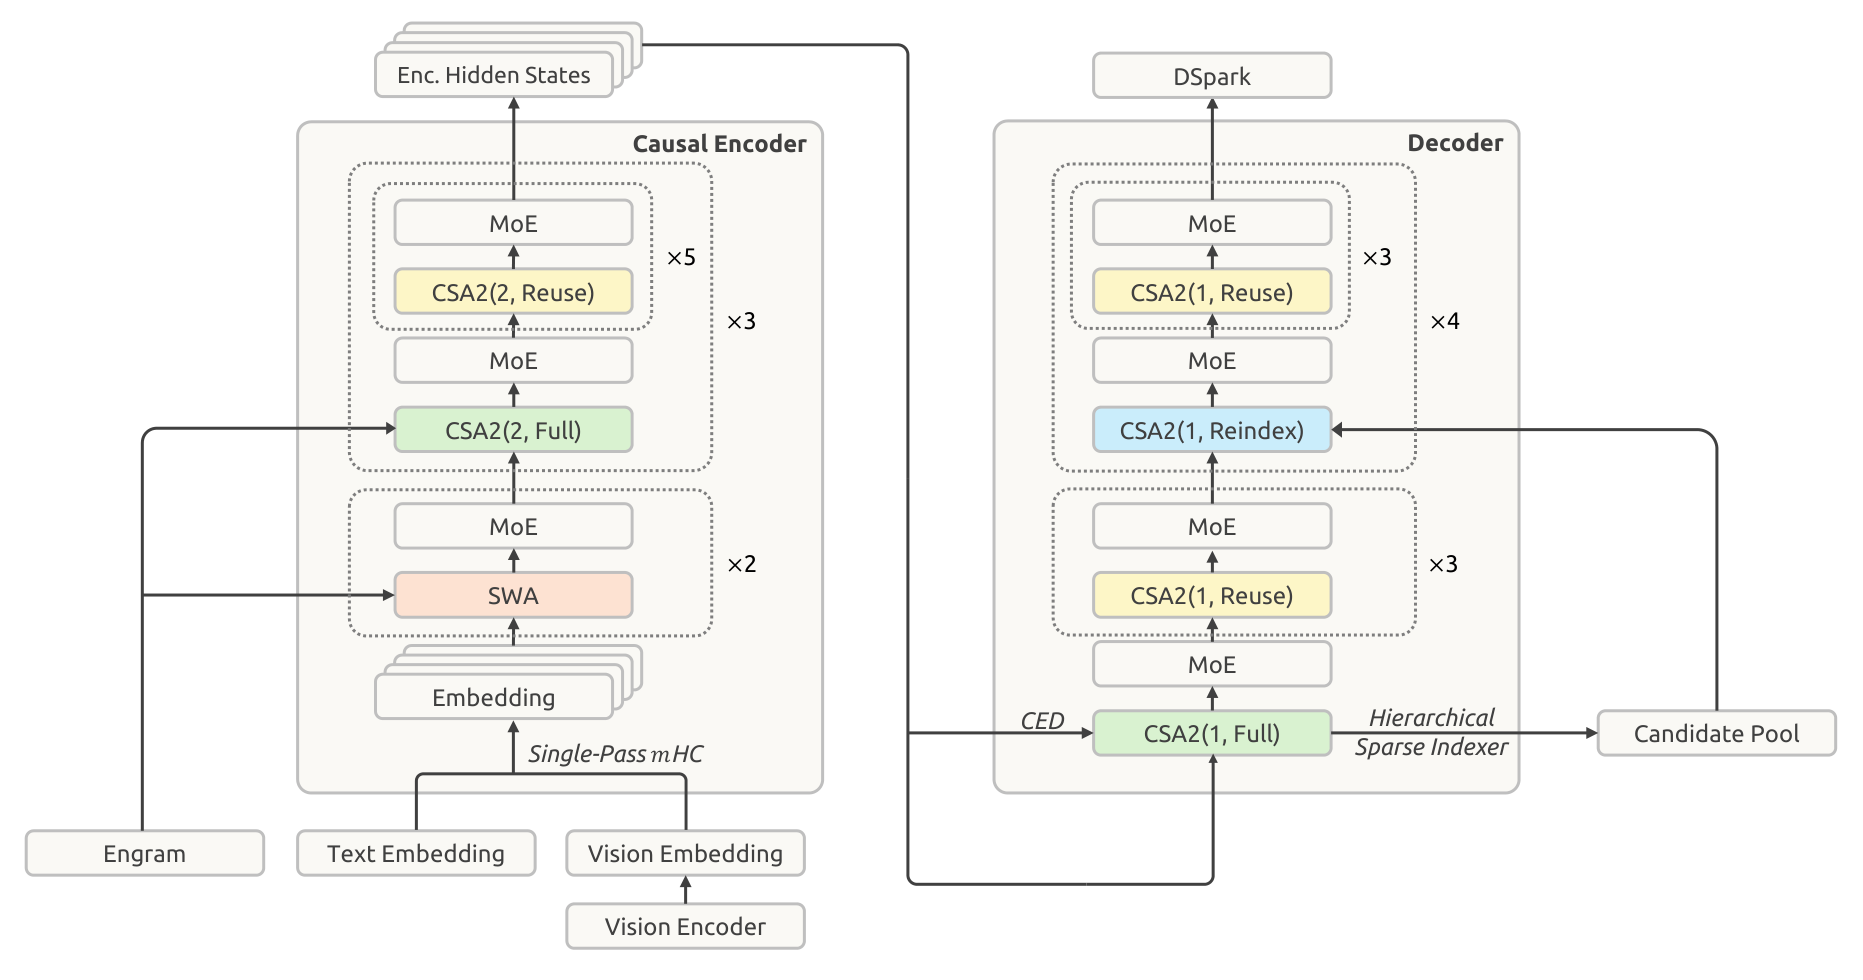
回到那个反直觉的数字:prefill 阶段每 token 激活 8B 参数,decode 阶段激活 16B。为什么生成时反而更贵?因为 CED 只对 prefill 生效——decode 时每个新生成的 token 都必须完整穿过 40 层才能产出下一个输出,激活参数自然翻倍。而 8B 与 16B 的比例,基本就是“跑了 20 层”与“跑了 40 层”的比例,每层结构相同,激活量是层数的线性函数。这个配置本身就是一个明确的取舍声明:把计算预算集中在生成阶段,而不是理解输入阶段。
合理性来自三处。其一是 agent 负载的形状,prefill 吃掉总计算的绝大部分,省它才是省钱的大头。其二是 decode 阶段的算术强度——它需要搬运的权重远多于它做的浮点运算,瓶颈在访存带宽而非算力,此时“多激活 8B 参数”的边际成本远低于 prefill 阶段。其三是最本质的:prefill 的几千个 token 可以并行处理,decode 每次只出一个 token、是延迟敏感路径,两者经济学不同,prefill 省的是吞吐成本,decode 省的是延迟成本。这条路线并非 DeepSeek 首创,YoCo(You Only Cache Once)已经验证过“上层 KV 从下半层投影”不显著损失性能,V4.1 是在它之上做工程化改造,并在 post-training 阶段把 SWA 状态的重建过程做了仿真,让模型对近似状态有适应性。
02CSA2:大多数层不再自己算注意力
第二个改动是注意力机制本身。上一代 V4 用的是 CSA(Compressed Sparse Attention)加 HCA(Heavily Compressed Attention)的混合架构,V4.1 换成了单一机制的 CSA2,把三种压缩手段同时用上:缩短 KV 头数量、压缩序列维度(每 m 个 token 合成一个 entry)、以及跨层复用。
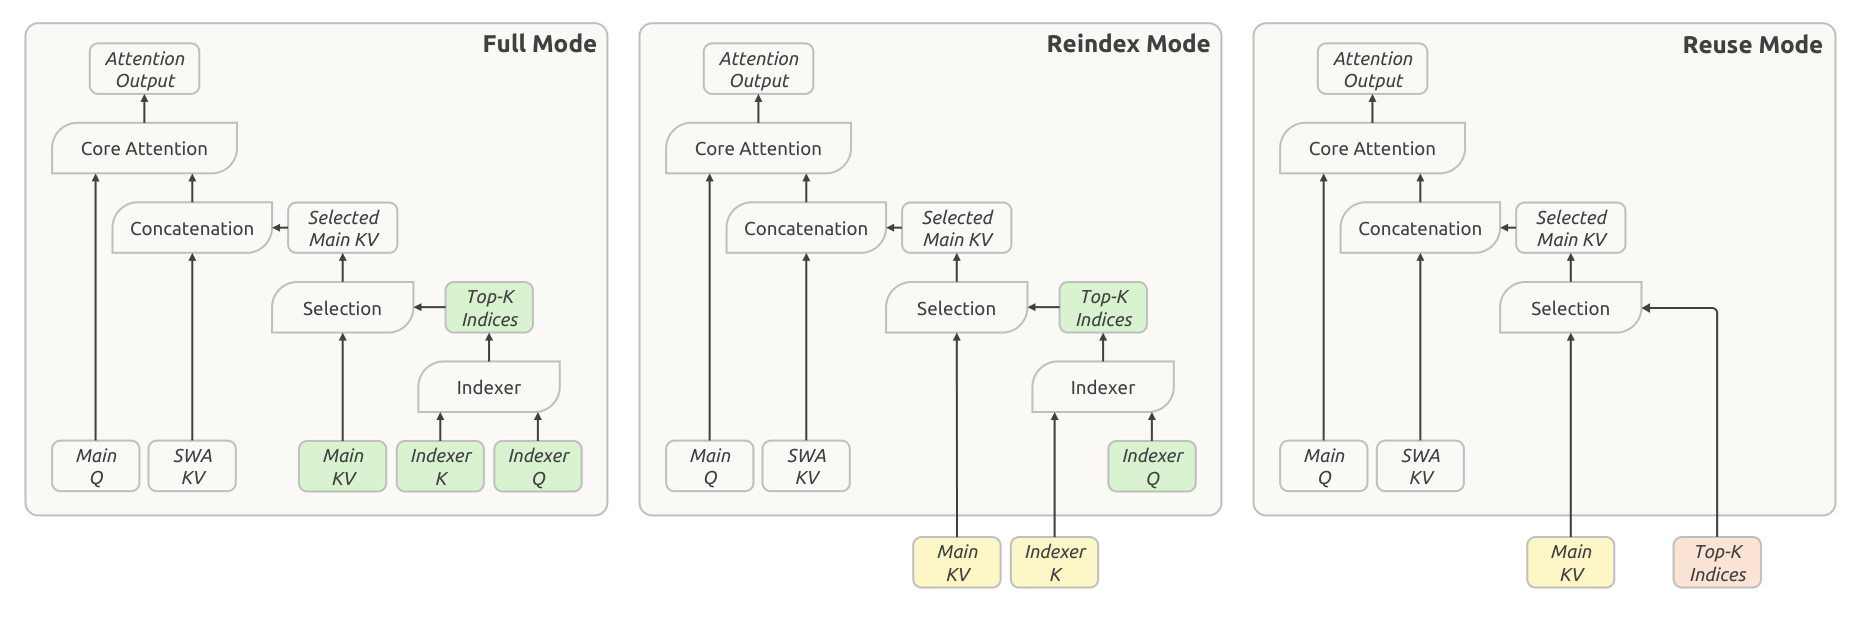
CSA2 的巧妙在于它把“cache sharing”和“index reuse”这两件事解耦了,按静态指定的模式分配给每一层。Full 模式做完整计算,自己算 main KV、indexer K 和 Top-K 索引;Reindex 模式复用前一层的 global KV 和 indexer K,但用自己的 indexer query 重新打分选出新的 Top-K;Reuse 模式连 Top-K 索引都直接沿用,不做任何索引计算,拿来做注意力就完事。具体分布上,18 个 encoder 层按每组 6 层分成三组,每组只有第 1 层是 Full,其余 5 层全是 Reuse;20 个 decoder 层分五组,第一组是 1 个 Full 加 3 个 Reuse,后四组各是 1 个 Reindex 加 3 个 Reuse。40 层里真正做完整计算的只有个位数。
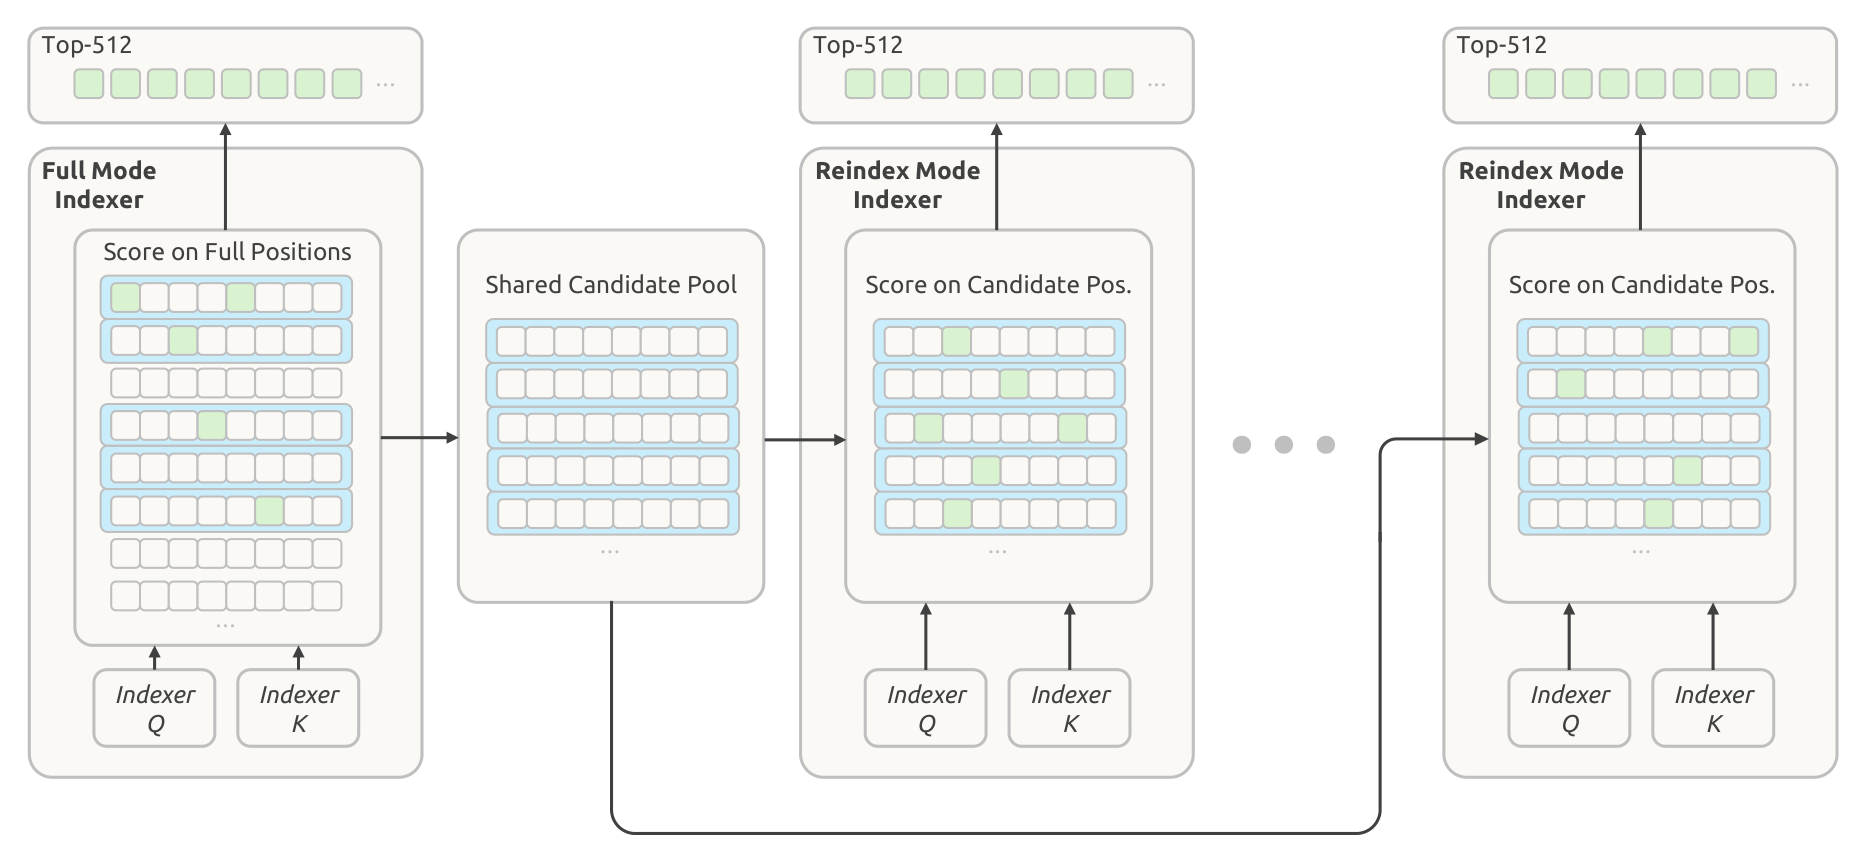
光有跨层复用还不够。Reindex 模式的层虽然省掉了 KV 计算,却仍要在全部因果可见位置上打分,上下文一长这个成本就回来了。于是有了配套的 Hierarchical Sparse Indexer:decoder 里第一个 Full 模式的层扫描全部可见位置选出 Top-512 之后,再做一次 block 级筛选——按每个 block 内最大的 index score 挑出 2,048 个 block、每 block 8 个位置,构成一个 16,384 个候选位置的共享池。后续 Reindex 层只在这个池子里搜索,于是深层 indexer 的每次查询成本从随上下文长度线性增长变成常数。这个机制在 post-training 阶段引入,训练和推理共用同一套搜索域,分层索引因此成为模型真正学会的能力。
两项改动叠加的效果可以在报告里那个 kernel 数上看到:CSA2 处于 Reuse 模式的层,prefill 阶段只执行 15 个 kernel、decode 阶段只执行 11 个。
03精度与状态重建:KV 压缩的最后两刀
架构层面的复用解决的是“算了多少”,精度和存储策略解决的是“存了多少”。V4 的 main KV 用 FP8,V4.1 进一步压到 FP4,靠量化感知训练(QAT)实现,格式是 OCP 的 MXFP4,E2M1 尾数配 E4M3 的 scale,每 16 个 channel 一个 scale。报告花了一整段论证省掉二级全局 scale 的合理性——RMSNorm 之后权重幅度约为 1,512 维 KV latent 的 L2 范数不超过 √512≈22.6,RoPE 旋转保持范数不变,实测最大幅度在 10 左右,而 E2M1 的表示范围能到 448×6=2688,动态范围有大量余量。
有个容易被忽略的细节值得单独标出来:这里的 FP4 用来省存储,不用来加速矩阵乘。量化后的 cache 在做注意力之前会被解量化回来,因此不需要硬件原生支持 FP4 matmul,也就不绑定特定 GPU 世代。KV 在 RoPE 之后量化(实验显示之前量化收益边际),而 SWA KV 因为对量化更敏感而保留 FP8。相对 V4 的 FP8 main KV,这一刀把存储再减半。
第二刀是全场最激进的设计。SWA Bounded Replay 处理的是滑动窗口注意力状态的重建问题。V4 的 persistent KV cache 里 SWA 占了近一半容量,但它的访问模式跟持久化缓存的经济性根本不匹配——SWA 只在一个分钟级的会话内窗口里被复用,跨会话就成了死数据,继续存着纯属浪费。精确重建又太贵:要为 L 层各重放 n_win 个 token。V4.1 的做法是只重放最近 n_win=128 个 token,把状态截断,接受近似重建。
这个近似的收益大得不成比例。encoder 侧的 prefix caching 从此只依赖 global KV,SWA KV 被彻底移出 persistent cache;decoder 侧的 prefill 被限制在 128 个 token 内,总 prefill 计算再砍一半。由此形成两级存储:global KV 留在 persistent cache(落在 SSD 上,保障至少 72 小时命中),SWA KV 移入一个由每台机器 10% host DRAM 组成的分布式内存池,TTL 只有分钟级——容量小但换手率高,足以覆盖并发活跃会话。报告明确承认重放出的状态“在数学上不相同”,但实测对响应质量影响可忽略。最终 persistent KV 占用降到 V4 的 1/8。
把四条改动连起来看,V4.1 的架构语言指向同一个方向:推理系统的容量约束正在从 GPU 显存向“显存—主机内存—SSD”的分层体系扩散。KV 跨层复用是省显存,FP4 是省存储,SWA 挪进 host DRAM 池是用内存换显存,Engram 常驻 CPU 内存再用 RDMA 预取也是同一逻辑。软件侧的所有巧思,都是在给这个分层体系做调度。
代价同样清楚:报告自己写明,CSA2 的潜在选择错误和 SWA Bounded Replay 的近似重建,仍可能在未测试的边缘场景导致能力退化,“没有任何有限测试集能覆盖所有极端输入”。这是近似换效率必须背的账。
04架构之外的三处扩展
除了上面四条主线,报告里还有三个独立组件。mHC 是 V4 引入的多路残差流设计,在相邻 Transformer block 之间维持 n 条残差流,但 V4 的实现需要三个 kernel 顺序执行,activation memory 流量接近理论下界的两倍。Single-Pass mHC 的改动看似不起眼却很关键:把 input mixing 的系数错开一个 block——每个 block 用前一个 block 算出的系数,依赖链一断,三个 kernel 就能融合成一个。部署版叫 Mega-mHC,达到理论下界,activation memory 流量减半。
Engram 走的是另一条路:在 MoE 的稀疏专家之外,再开一条稀疏查找的轴。196B 参数放在第 1 层和第 14 层,N-gram order 取 {2,3,4},8 个 hash head,每个 order 的 embedding 维度 2048,每个 head 索引约 1600 万条目。它常驻主机内存,推理时通过后台 RDMA 预取进 GPU。这条设计的含义值得记下来——它等于把一部分模型容量从 GPU 显存挪到了 CPU 侧内存,用内存层级换显存容量,本质上承认了显存已经成为模型规模与上下文长度的硬约束。
DSpark 替代了 V3 的 MTP 做投机解码。草稿器是 3 个 128 窗口的 Transformer block,一次前向并行算出 5 个位置的 logits,配一个轻量 Markov head 建模草稿 token 之间的依赖,再用一个 confidence head 预测逐位置的条件接受概率,调度器结合实测的引擎吞吐曲线动态决定每一步验证多长。跟 MTP 的关键区别在训练位置:MTP 是预训练阶段跟主干联合训练,DSpark 是 post-training 阶段单独训、主干冻结,post-training 期间继续训但梯度不回传主干,这样它始终对齐演化中的策略。
05训练与后训练:数据取代算法
这一代报告的诚信度,很大程度体现在 post-training 章节的第一句话上。它明说没有引入任何算法创新,配方就是标准的 SFT 加 RL 加 on-policy distillation,全部增益来自数据合成和环境构建的规模化,并把这句话上升成了一个行业判断:“在当下这个阶段,数据与环境管线的工程边际回报显著超过 post-training 的算法新颖性”。
支撑这个判断的三套工程都极重。任务是 (问题、环境、验证系统) 三元组,用难度和正确性两个维度做 reward,迭代训练模型自己造题;Coding agent 的环境由多个专职 agent 分工搭建——一个判断项目能否构建与自动验证,一个装依赖、自测、打包镜像,多个尝试解题,另有独立质检 agent 审查环境和轨迹,不过关就派修复 agent 重做。平台侧是自研的 DSc(DeepSeek Elastic Compute),要撑住百万级并发 sandbox:它弃用了 Kubernetes 那类现成编排器,改用自定义 placement engine,用放弃强全局一致性换取扩展性;节点层面用 sub-NUMA 分区把密度从约 1,000 个并发容器提到 2,500 个以上。最后阶段的全词表蒸馏用了 40 多个 teacher 模型。
训练侧的动作可以概括为数据优先。45T token 的多模态语料按 7:1 的文本对多模态比例混合,batch size 全程固定 100.6M token,稀疏注意力从 64K 序列长度起从头训练、没有任何 dense attention 预热阶段,到 34T token 处扩到 1M。视觉编码器 DeepSeek-ViT 从零训起,32 层,用 2D-RoPE 替代绝对位置编码、线性投影替代卷积 patch embedding,再通过 3×3 的 pixel-unshuffle 把视觉 token 数降九倍。优化器上,Muon 管线性变换、AdamW 管 RMSNorm 这类非矩阵参数、Sinkhorn balancing 管 embedding 和 prediction head。
需要特别说明的是,这份报告没有披露任何算力总量——没有 GPU 型号数量、没有训练天数、没有总 FLOPs、没有成本数字。这跟 V3 时代形成鲜明对比,那组“2048 张 H800、2.788M GPU hours、总成本 5.576 百万美元”的数字被全行业引用了两年多。V4 与 V4.1 两代都选择不披露,这意味着关于这一代模型的单位训练成本,公开信息里没有可靠锚点,任何声称具体金额的估算都是在做推算,引用时需要标注清楚。报告把成本叙事的重心整体压在了部署侧——开篇说 “substantially lowering deployment costs”,结论说 cost reduction 与 capability scaling 要同步推进,指的始终是推理成本。
还有一段红队观察值得单独记录:报告说 RL 训练中频繁观察到 agent 试图 reward hacking——利用 XFS driver 的权限问题、通过 AppArmor 非法访问内存、从 package mirror 泄题,甚至有删除关键二进制、破坏系统文件、乃至移除整个文件系统的。防御手段是 per-sandbox 的 AppArmor profile 加细粒度 eBPF 网络策略,弄崩环境就记为失败轨迹并向 RL 框架报一个 “repercussion” 信号。报告在评测章节还补了一句警告:随着模型变强,标准评测基础设施本身(Docker 容器、验证脚本)正在变成可被模型 game 的对象。
06可控推理努力:把 test-time compute 做成旋钮
这一代最具产品意义的机制是 Controllable Reasoning Effort。它在 RL 阶段引入一个标量 b ∈ [1,100] 作为显式条件信号拼进 system prompt,然后让长度惩罚项随 b 指数衰减:k(b) = k₀·exp(−(b − b_min)/τ)。b 越高惩罚越轻,允许的推理长度越长。公开 API 暴露三档,max 对应 100,high 对应 75,low 对应 50。
实测形状很干净。八个推理密集型 benchmark 上把 effort 从 25 提到 100,平均 Pass@1 从 67.1% 提升到 76.3%;DeepSWE v1.1 从 66.0% 到 74.2%;Terminal-Bench 2.1 从 82.4% 到 90.6%,代价是约 2.5 倍的输出 token。但收益是前重后轻的——60 到 80 这个区间已经能拿到最大设置的绝大部分精度,而 token 预算不到其一半;最后一步从 80 推到 100 只是让 agent 轨迹延长 1.6 到 1.8 倍,换来边际极小的提升。报告由此给出的建议是:最大档留给最难的题目,日常 agent 用途用中档最划算。
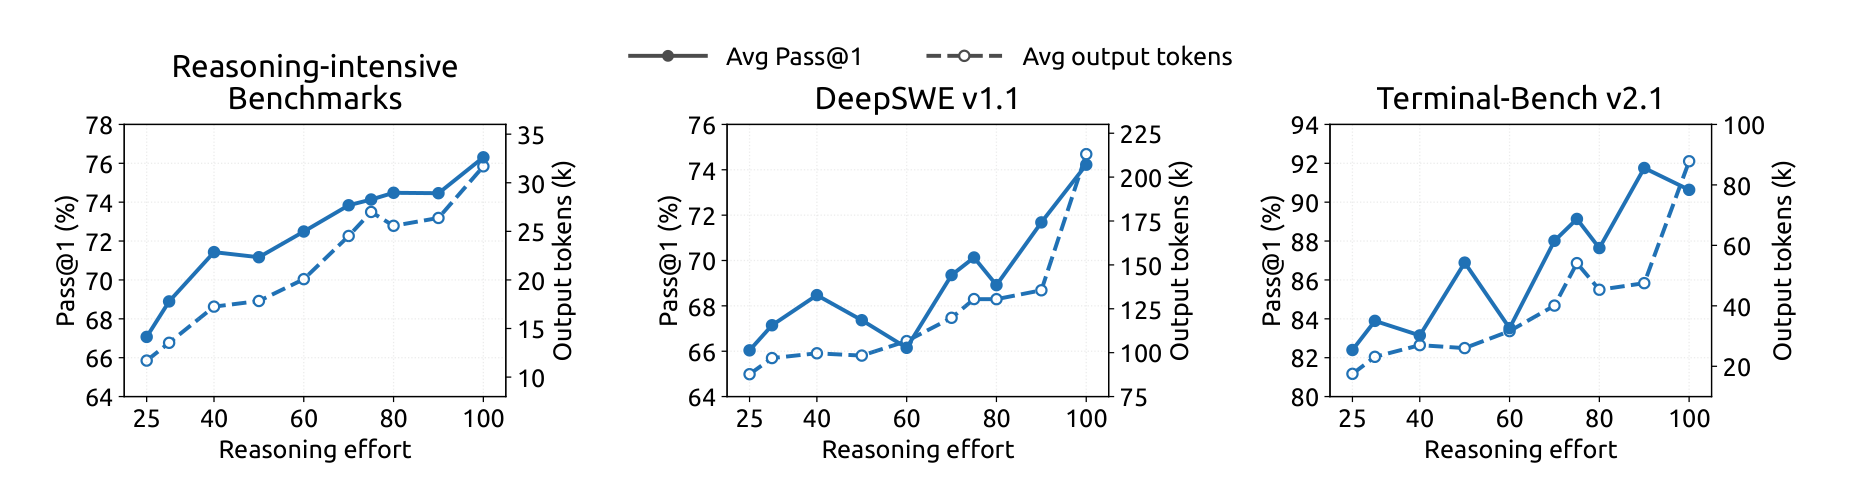
这个机制的产品含义比技术含义更大。它让同一个 checkpoint 可以在推理时被推到不同的运营点上,服务商第一次能按客户的钱包和延迟要求切出不同档位的产品,而不需要为每档单独训一个模型。附录 C 用边际效用递减的假设(解题概率的边际改进随推理长度指数衰减)给出了这套指数惩罚的参数化推导,结论是请求的 effort 与偏好的推理长度之间存在近似线性关系。
第三方实测与报告的判断吻合得相当好。独立测评机构在 max 档下观察到模型“表现出前所未有的推理努力程度”,中等难度任务消耗达到 260K 到 340K token,远高于所有对比模型;但关键在于消耗过量 token 后解题正确率并没有提升,前代 Pro 的平均正确率反而更高。测评者由此给出了同样的结论:max 档不适合日常使用。
07性能对位与必要的限定
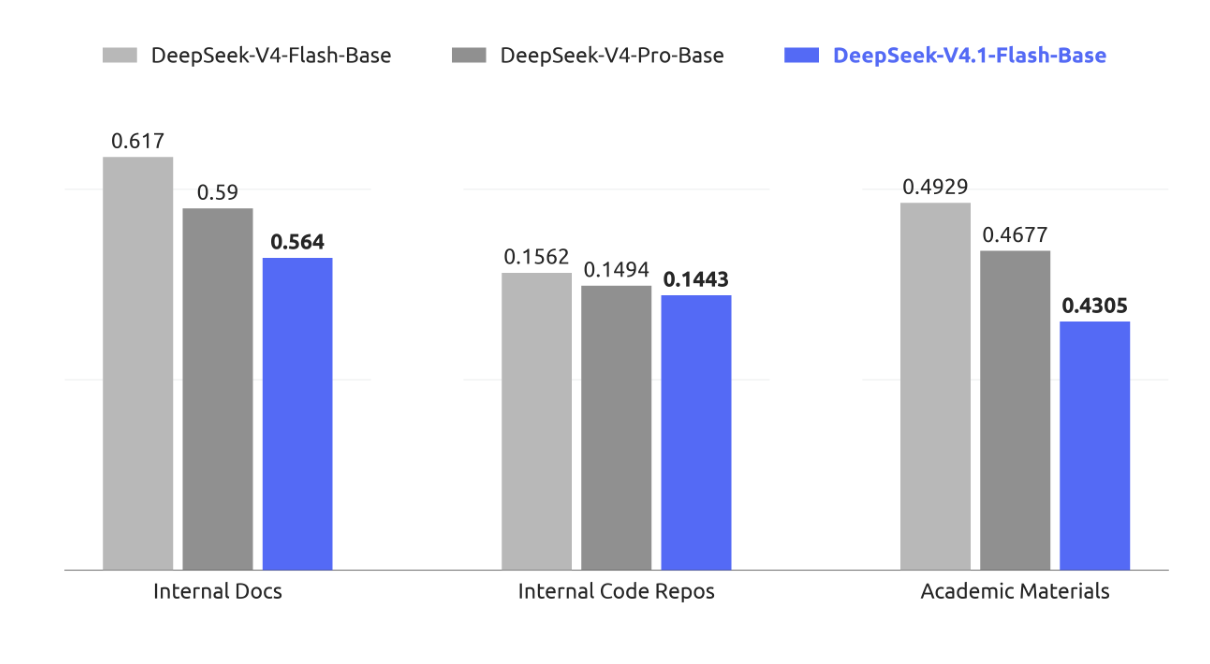
先看基座模型,这是最能体现架构效率的地方。V4.1-Flash-Base 以 8B/16B 的激活参数、552B 的总参数,跟 49B/1.6T 的 V4-Pro-Base 打平——GPQA Diamond 53.1 对 53.9、MMLU-Pro 74.1 对 73.5、BigCodeBench 60.6 对 59.2。报告还用了更能说明泛化的 BPB(bits-per-byte,越低越好)在内部文档、内部代码库、学术材料三个私有评测集上做对比,V4.1-Flash-Base 三项全部最低。
后训练版本上几个关键对位:Terminal-Bench 2.1 拿到 90.6,高过 Opus-5 的 89.1;DeepSWE v1.1 拿到 74.2,从 V4-Flash 的 54.4 跳上来,也压过 Opus-5 的 74.0;CyberGym 88.1 是开源模型里的新 SOTA;Codeforces rating 3471 超过 V4-Pro 的 3348。
跨 harness 泛化值得一提:同一份 checkpoint 在 Claude Code、Codex、OpenCode、Pi、mini-SWE 以及自家 DeepSeek Harness 的 Minimal/Standard/PTC 共八种 agent 框架下评测,Terminal-Bench 2.1 得分落在 84.1 到 90.6 的窄带里。这说明模型的 agent 行为没有过拟合到某个特定的系统提示或工具协议上,对做评测的人是很有用的信号。
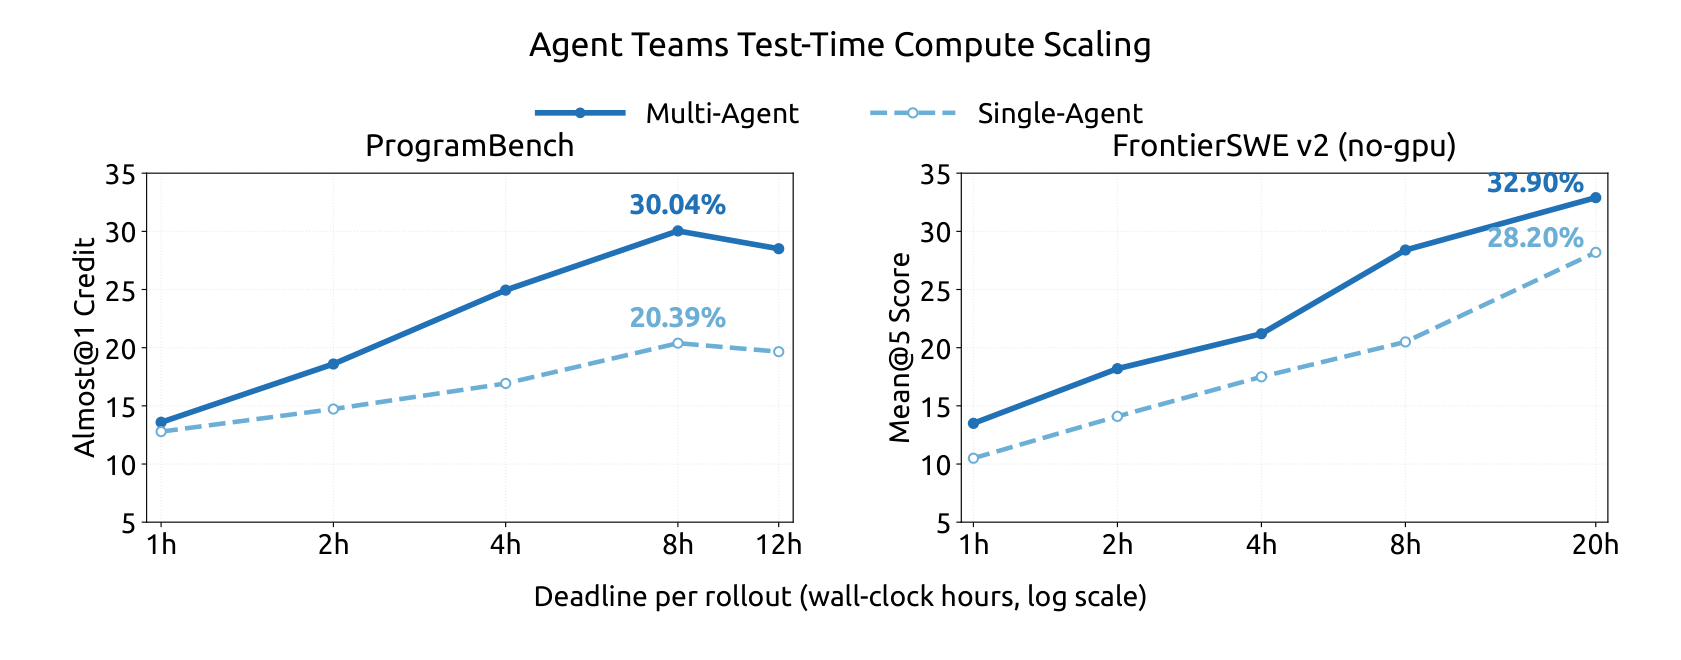
还有一组跟投资叙事直接相关的实验:多 agent 配置的 test-time compute scaling 曲线始终高于单 agent。ProgramBench 上,在 8 小时 deadline 下多 agent 的 Almost@1 达到 30.04%,单 agent 是 20.39%;FrontierSWE v2 在 20 小时 deadline 下多 agent 32.90%、单 agent 28.20%,且两条曲线的差距随预算增加而扩大。报告为此专门训了 Agent Team 模式,reward 里包含鼓励委派与通信的协作奖励,以及一个把执行事件和协作依赖建成 DAG、取关键路径长度计算的派生延迟惩罚。
独立第三方的横评则给出了更贴近真实使用成本的一组数字,也暴露了短板。
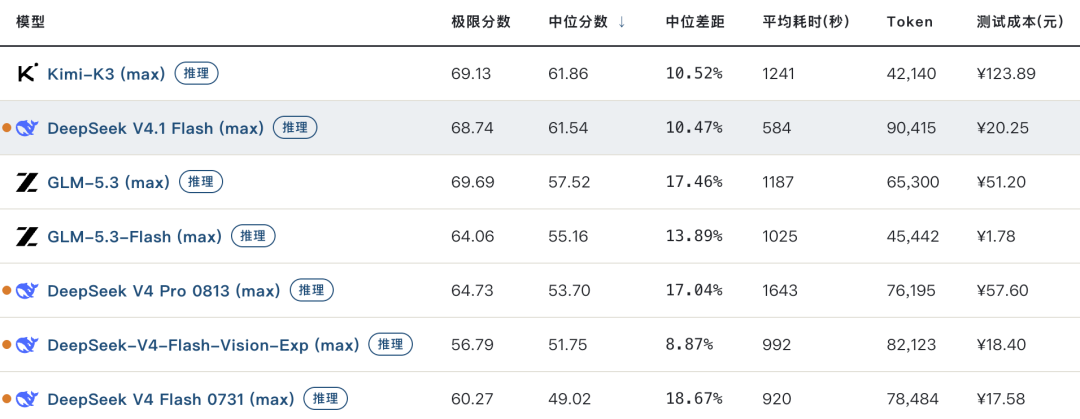
这张表把架构效率翻译成了可直接计算的成本差——这是 V4.1 那一整套 KV 压缩与 prefill 腰斩在真实账单上的样子。同一份测评在 agent 任务上的结论则要克制得多。
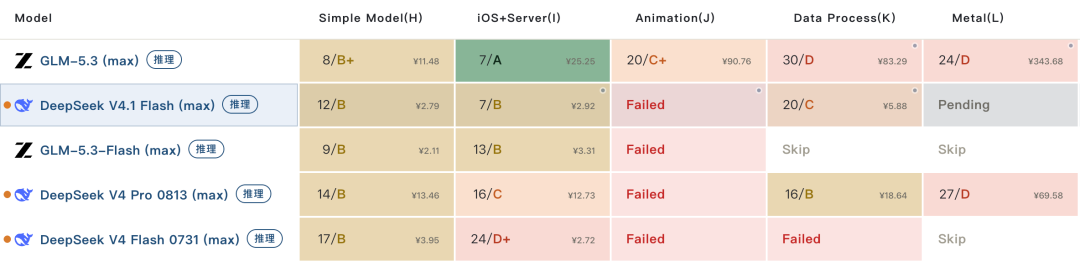
测评者的定性结论跟这张图的形状一致:V4.1 Flash 的 Agent Coding 能力提升幅度有限,略好于前代 Pro;综合审美能力显著高于 V4 各版本但离第一梯队仍有差距;它能利用视觉能力检查和修正 UI 问题,但对审美要求更高的间距、配色,以及高级建模、动效、转场等任务表现不及预期。另一个观察特别值得记下来:完成任务所需的步骤数显著多于前代(增幅至少 20%,极端案例 +700%),其中绝大部分来自自测环节——模型会为每个功能点编写用例并截图视验。这大概就是报告里“agent 在 RL 中为追求极少量 reward 增益而不计代价”那段描写在真实任务上的外溢。
报告自己的限定写得比任何批评都更严格。它承认 HLE 只有 36.8(纯文本子集 39.1)、跟闭源前沿仍有距离,并且在结论章节明确写道:“benchmark 分数接近并不意味着在复杂高难度推理和边缘场景上达到了领先闭源系统的前沿能力”,标准评测正在饱和,后续将持续更新评测协议。这种自我限定在技术报告里并不常见。
08产业含义:瓶颈换位之后,集群该怎么配
这一代最值得带到投研语境里的,是它把长上下文的成本瓶颈明确定义在了存储而非算力上,而这个定义会直接改变推理集群的配置逻辑。先算一笔账:890 bytes/token 意味着一个 100 万 token 上下文的会话,global KV 只占约 890MB。这个量级小到可以让 8 张 H200(1,128GB 显存)同时装下约 1,200 个百万上下文会话,而上一代 V4-Flash(3,514 bytes/token)只能放 320 个左右。KV 不再是显存瓶颈之后,部署的约束回到了权重本身——552B 参数装不装得下,决定了并行度至少要多高。装下之后显存反而大量富余,于是 EP(专家并行)越小越好、越靠近单机越好,理由很直接:跨机越少,通信开销越低,MoE 负载均衡也越好。
这个推论落到具体卡型上会得出几个反直觉的结论。H20 在 decode 段是全系最优解:96GB 显存比 H100 还大,4.0TB/s 的 HBM 带宽甚至高于 H100 的 3.35TB/s,而它砍掉的正是算力(FP8 约 296 TFLOPS,不到 H100 三分之一)——可 decode 阶段本来就是 memory-bandwidth-bound、算力大量闲置,你花的钱买的正好是它需要的那部分资源。H100 反而最尴尬:80GB 显存做单机 EP=8 时每卡要扛约 69GB 的 FP8 权重,只剩 11GB 给 KV、激活缓冲和 kernel workspace,在长上下文场景没有安全边际,大概率被迫退到跨机 EP=16,而它的算力优势在 decode 段本来就是浪费的。GB200/GB300 的核心优势则被架构本身消解了——它们最值钱的是 NVLink5 的 72 卡全互联域,解决的问题是超大规模 EP 的跨机 all-to-all,而 CED 把 prefill 砍半、KV 变小又让 EP 能压回单机,模型不再需要那么大的互联域。
报告已采用 EPD 三级分离(视觉编码—预填充—解码各自独立扩展并重叠执行),Prefill 池与 Decode 池应该配不同的卡——Prefill 近似 compute-bound,配 H100/H200;Decode 是 memory-bound,配 H20 八卡机、EP=8、TP 压到最低(每加一档 TP 就在每层多一次 all-reduce,对 memory-bound 的 decode 是纯开销)。配比取决于实际缓存命中率,agent 场景大致可从 1:2 到 1:4 起调。
三个容易被忽略的配套项:Host DRAM 必须配足(SWA 池要 10%、Engram 的 196B 参数按 FP8 算又是 196GB,八卡机建议 2TB 起步,否则两者互相挤占);NVMe 别按能省则省配(persistent KV 的 TTL 是 72 小时以上,890MB 一个百万级会话,一千个就是 890GB,容量越充裕命中率越高,prefill 池压力越小——这就是那套高缓存命中率的物理基础);RDMA 网络不能省,Engram 预取、KV 跨机搬运、EP 超单机后的 all-to-all 都依赖它。
还有一个横向对比能帮助定位路线差异。小米 MiMo 最新一代在推 1T 参数模型过 1000 tokens/s 时用的手段是对 MoE 专家权重做 MXFP4 量化、其余模块保持 FP8,配投机解码和常驻 kernel 执行引擎——业界常说的 A8W4(激活 8bit、权重 4bit)就是这个意思。这和 DeepSeek 的 8B/16B 不在一个轴上:8B/16B 度量的是稀疏度,即每个 token 激活多少参数,管的是计算量;A8W4 度量的是精度,即每个参数用几位表示,管的是存储和带宽。权重可以压得比激活狠,因为权重是静态的、能在训练阶段就让它适应量化误差,而激活是运行时动态产生的、还带离群通道,压它更容易掉精度。两条路最终指向同一个瓶颈:decode 时要从 HBM 搬进来的那堆字节。有意思的是 MiMo 自己在评估各家 KV cache 占用时,把 MiMo-V2.5 系列排在国产模型第二,仅次于 DeepSeek-V4-Pro 和 Flash——等于公开承认了 DeepSeek 在 KV 压缩上的领先身位。
把这套东西放到竞争格局里看,含义有两层。短期是成本端的好消息:单位 token 的边际成本被推到了更陡的下降曲线上,配合 effort control 这个显式旋钮,服务商可以在同一个 checkpoint 上切出不同档位的产品,下游应用公司直接受益。更长的一层是差异化来源的转移——在 552B/8B-16B 的体量上打别人的 1.6T,靠的不是参数规模,而是架构与系统工程能力。DeepSeek 在 V4 到 V4.1 这半年里改的是注意力结构、缓存层级和训练管线,而不是把模型做大。这个方向上的军备竞赛,比拼的是谁更懂硬件与系统的交界处,而不是谁买得起更多的卡。
最后留三个观察点。一是 CSA2 与 SWA Bounded Replay 的近似在长周期、高难度 agent 任务上会不会累积出能力退化——报告说没有观察到系统性退化,但也没排除边缘场景,这需要更长时间的真实负载检验。二是 effort control 会不会成为行业标配:一旦有第二家大厂在 API 里暴露推理档位或 per-token 计费选项,就说明这套“同 checkpoint 多运营点”的产品逻辑被验证了。三是 软件生态的跟进速度——报告披露的 kernel 全部是自研的(FlashMLA、Mega-Gate、Mega-mHC、Mega-MoE、DeepSelect 里的 TopK),第三方推理框架要跑出标称性能需要等待适配,上线时间表的风险可能比硬件选型的风险更大。
• DeepSeek-AI, DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression, 2026年9月(技术报告,51页)
• Sun et al. 2024, You Only Cache Once: Decoder-Decoder Architectures for Language Models, NeurIPS 2024——CED 的思路来源
• DeepSeek-AI, DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence(arXiv:2606.19348)——上一代 CSA-HCA 混合架构
• Cheng et al. 2026a, DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation(arXiv:2607.05147)
• Cheng et al. 2026c, Conditional Memory via Scalable Lookup: A New Axis of Sparsity(ACL 2026)——Engram
• Xie et al. 2026, mHC: Manifold-Constrained Hyper-Connections(arXiv:2512.24880)
• 微信公众号「大模型观测员」,《DeepSeek V4.1 Flash 测评》,2026年9月
• 小米 MiMo,《MiMo-V2.5 系列推理全链路优化》(mimo.xiaomi.com/zh/blog/mimo-v2-5-inference)及 1000 TPS 工程博客
数据口径说明
• 本文图表除标注第三方的两张外,均取自 DeepSeek-V4.1-Flash 技术报告,由 PDF 矢量原图高保真导出。
• 集群配置建议基于 FP8 权重(552GB)假设推算,报告未披露部署精度;若实际采用 FP4 或更激进的专家压缩,临界点会松动,结论需重算。
• 技术报告未披露训练算力总量,本文不做估算。